Sommaire
Le déploiement continu (continuous deployment, ou CD) consiste à mettre en ligne automatiquement chaque modification validée par l'équipe. C'est la dernière étape de la chaîne d'intégration continue : elle n'intervient que si les étapes précédentes (tests, analyse du code, build) sont passées.
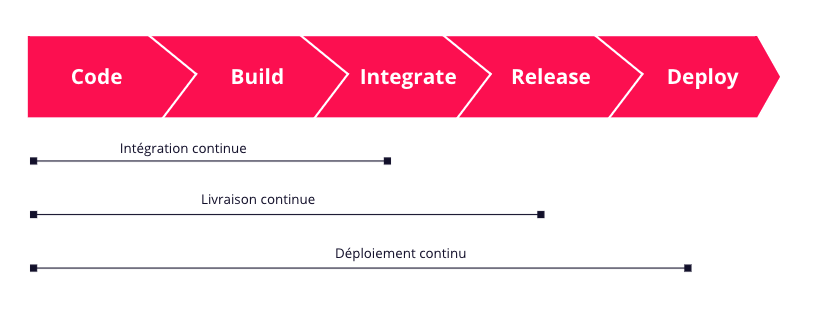
Automatiser le déploiement fait gagner un temps précieux à chaque livraison. Surtout, chaque modification est disponible aussitôt sur l'environnement de recette : les retours arrivent vite, les bugs sont repérés tôt, et les utilisateurs testent au fil de l'eau.
Dans cet article, nous mettons en place un pipeline complet avec GitHub Actions, Docker et Kubernetes :
- à chaque modification de la branche
develop, GitHub Actions construit l'image Docker de l'application ; - l'image est poussée sur un registre ;
- le cluster Kubernetes de staging est mis à jour, progressivement et sans interruption de service, avec un retour arrière automatique si la nouvelle version ne démarre pas.
La première version de cet article, en 2021, utilisait CircleCI et Ansible. Les principes restent les mêmes ; les outils ont évolué.
Prérequis
- Un dépôt GitHub contenant l'application, ici un service Node.js.
- Un cluster Kubernetes avec un namespace
staging, chez n'importe quel fournisseur (Scaleway, OVHcloud, AWS, Google Cloud…). - Un registre d'images. Nous utilisons ici GitHub Container Registry (
ghcr.io), intégré à GitHub ; le registre de votre fournisseur cloud fonctionne de la même façon.
Arborescence du projet :
.
├── .github/
│   └── workflows/
│       └── deploy.yml
├── k8s/
│   └── deployment.yaml
├── src/
├── Dockerfile
└── package.json
1. L'image Docker
Le Dockerfile construit l'image en deux étapes (multi-stage build). La première image compile l'application, la seconde ne garde que le résultat, sans les outils de build : l'image finale est plus légère et expose moins de surface d'attaque.
# ----- image de build -----
FROM node:22-alpine AS build
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci
COPY . .
RUN npm run build && npm prune --omit=dev

# ----- image finale -----
FROM node:22-alpine
WORKDIR /app
ENV NODE_ENV=production
COPY --from=build /app/node_modules ./node_modules
COPY --from=build /app/dist ./dist
COPY package.json ./
EXPOSE 8080
USER node
CMD ["node", "dist/main.js"]
On copie d'abord package.json et le lockfile seuls, pour que Docker garde en cache l'installation des dépendances tant qu'elles ne changent pas. Le service tourne avec l'utilisateur node, et non root.
2. Le déploiement Kubernetes
Le fichier k8s/deployment.yaml décrit comment le service tourne sur le cluster. Deux réglages font tout le travail du déploiement progressif :
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend
  namespace: staging
spec:
  replicas: 3
  selector:
    matchLabels:
      app: backend
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    metadata:
      labels:
        app: backend
    spec:
      imagePullSecrets:
        - name: ghcr
      containers:
        - name: backend
          image: ghcr.io/thetribe/backend:latest
          ports:
            - containerPort: 8080
          readinessProbe:
            httpGet:
              path: /health
              port: 8080
            initialDelaySeconds: 5
            periodSeconds: 5
strategy: Kubernetes remplace les instances une par une (maxSurge: 1) et ne retire jamais une ancienne instance avant que la nouvelle soit prête (maxUnavailable: 0). Le service reste disponible pendant toute la mise à jour.readinessProbe: une instance ne reçoit du trafic que lorsque sa route/healthrépond. Si la nouvelle version ne démarre pas, le déploiement reste bloqué et les anciennes instances continuent de servir les utilisateurs.
Ce fichier est appliqué une première fois à la main (kubectl apply -f k8s/deployment.yaml). Ensuite, la CI ne fera que changer la version de l'image.
3. Les secrets de la CI
Dans le dépôt GitHub, Settings › Environments, créer un environnement staging et y ajouter le secret KUBECONFIG_STAGING : le fichier de configuration d'un compte de service Kubernetes limité au namespace staging.
L'accès au registre ghcr.io ne demande pas de secret supplémentaire : GitHub Actions fournit un jeton temporaire (GITHUB_TOKEN) à chaque exécution.
Côté cluster, le secret ghcr cité dans le déploiement permet à Kubernetes de tirer les images privées du registre.
4. Le pipeline GitHub Actions
Le fichier .github/workflows/deploy.yml enchaîne deux jobs : construire l'image, puis la déployer.
name: Déploiement staging

on:
  push:
    branches: [develop]

env:
  IMAGE: ghcr.io/thetribe/backend

jobs:
  build:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      packages: write
    steps:
      - uses: actions/checkout@v4

      - uses: docker/setup-buildx-action@v3

      - uses: docker/login-action@v3
        with:
          registry: ghcr.io
          username: ${{ github.actor }}
          password: ${{ secrets.GITHUB_TOKEN }}

      - uses: docker/build-push-action@v6
        with:
          context: .
          push: true
          tags: ${{ env.IMAGE }}:${{ github.sha }}
          cache-from: type=gha
          cache-to: type=gha,mode=max

  deploy-staging:
    needs: build
    runs-on: ubuntu-latest
    environment: staging
    steps:
      - uses: azure/setup-kubectl@v4

      - name: Accès au cluster
        run: |
          mkdir -p ~/.kube
          echo "${{ secrets.KUBECONFIG_STAGING }}" > ~/.kube/config

      - name: Mise à jour de l'image
        run: |
          kubectl -n staging set image deployment/backend backend=${{ env.IMAGE }}:${{ github.sha }}
          kubectl -n staging rollout status deployment/backend --timeout=5m
Détaillons.
on: push: branches: [develop]: le pipeline se déclenche à chaque fusion surdevelop. Pour la production, on dupliquera le job avec la branchemainet un environnementproduction, protégé par une validation manuelle dans GitHub.- Job
build: il construit l'image et la pousse sur le registre. Le tag est l'identifiant du commit (github.sha), et nonlatest: chaque version déployée correspond exactement à un commit, et on sait toujours ce qui tourne. Le cache (type=gha) évite de tout reconstruire à chaque exécution. - Job
deploy-staging: il ne démarre que si le build a réussi (needs: build).kubectl set imageremplace la version de l'image dans le déploiement, ce qui lance la mise à jour progressive décrite plus haut.kubectl rollout statusattend la fin de la mise à jour : si les nouvelles instances ne deviennent jamais prêtes, le job échoue et l'équipe est prévenue, pendant que l'ancienne version continue de tourner.
Dans un vrai projet, un job de tests et d'analyse du code précède le build, et le build en dépend (needs: test).
5. Revenir en arrière
Si un problème apparaît après la mise en ligne, une commande suffit pour revenir à la version précédente :
kubectl -n staging rollout undo deployment/backend
Comme chaque image est taguée avec son commit, on peut aussi redéployer n'importe quelle version précise en relançant le pipeline sur ce commit.
Aller plus loin : le déploiement canary
La mise à jour progressive remplace les instances une par une, mais toutes les nouvelles instances reçoivent du trafic dès qu'elles sont prêtes. Pour les applications sensibles, le déploiement canary n'expose d'abord la nouvelle version qu'à une petite part des utilisateurs, puis augmente cette part par paliers.
Avec Argo Rollouts, le Deployment devient un Rollout et la stratégie se décrit ainsi :
strategy:
  canary:
    steps:
      - setWeight: 10
      - pause: { duration: 5m }
      - setWeight: 50
      - pause: { duration: 5m }
10 % du trafic, cinq minutes d'observation, puis 50 %, puis 100 %. Couplé à une analyse automatique des métriques (taux d'erreur, temps de réponse), le déploiement s'interrompt et revient en arrière de lui-même si la nouvelle version se dégrade.
Le tour est joué
À chaque fusion sur develop, la chaîne construit l'image, la pousse sur le registre et met à jour le staging sans interruption, avec un filet de sécurité si la nouvelle version ne démarre pas.
C'est une base solide, qui fait déjà gagner un temps précieux à chaque modification. On peut ensuite :
- ajouter l'environnement de production avec une validation manuelle ;
- confier le déploiement à un outil GitOps comme Argo CD, qui synchronise le cluster sur un dépôt de configuration ;
- créer des environnements de test éphémères par pull request avec Terraform.
Pour découvrir le rôle de chacun de ces outils, lisez notre article DevOps : les principaux outils à connaître.